Jina AI-Suchmodelle
Frontier-Modelle für Aufnahme und Abruf
Jina AI-Modelle bewahren die Bedeutung von Aufnahme bis Abruf Erzielen Sie Spitzengenauigkeit zu einem Bruchteil der Rechenkosten, in Ihrer Cloud, On-Prem oder nativ auf Elasticsearch.
KI-Modelle, die die Bedeutung von Dokumenten bis hin zu Antworten bewahren
Jina AI entwickelt kleine Modelle der Spitzenklasse für eine präzise und kosteneffiziente Dokumentenaufnahme, mehrsprachige Einbettungen über Text und Medien hinweg sowie Reranking. Sie werden nativ auf Elasticsearch ausgeführt und erfordern keine Konfiguration.
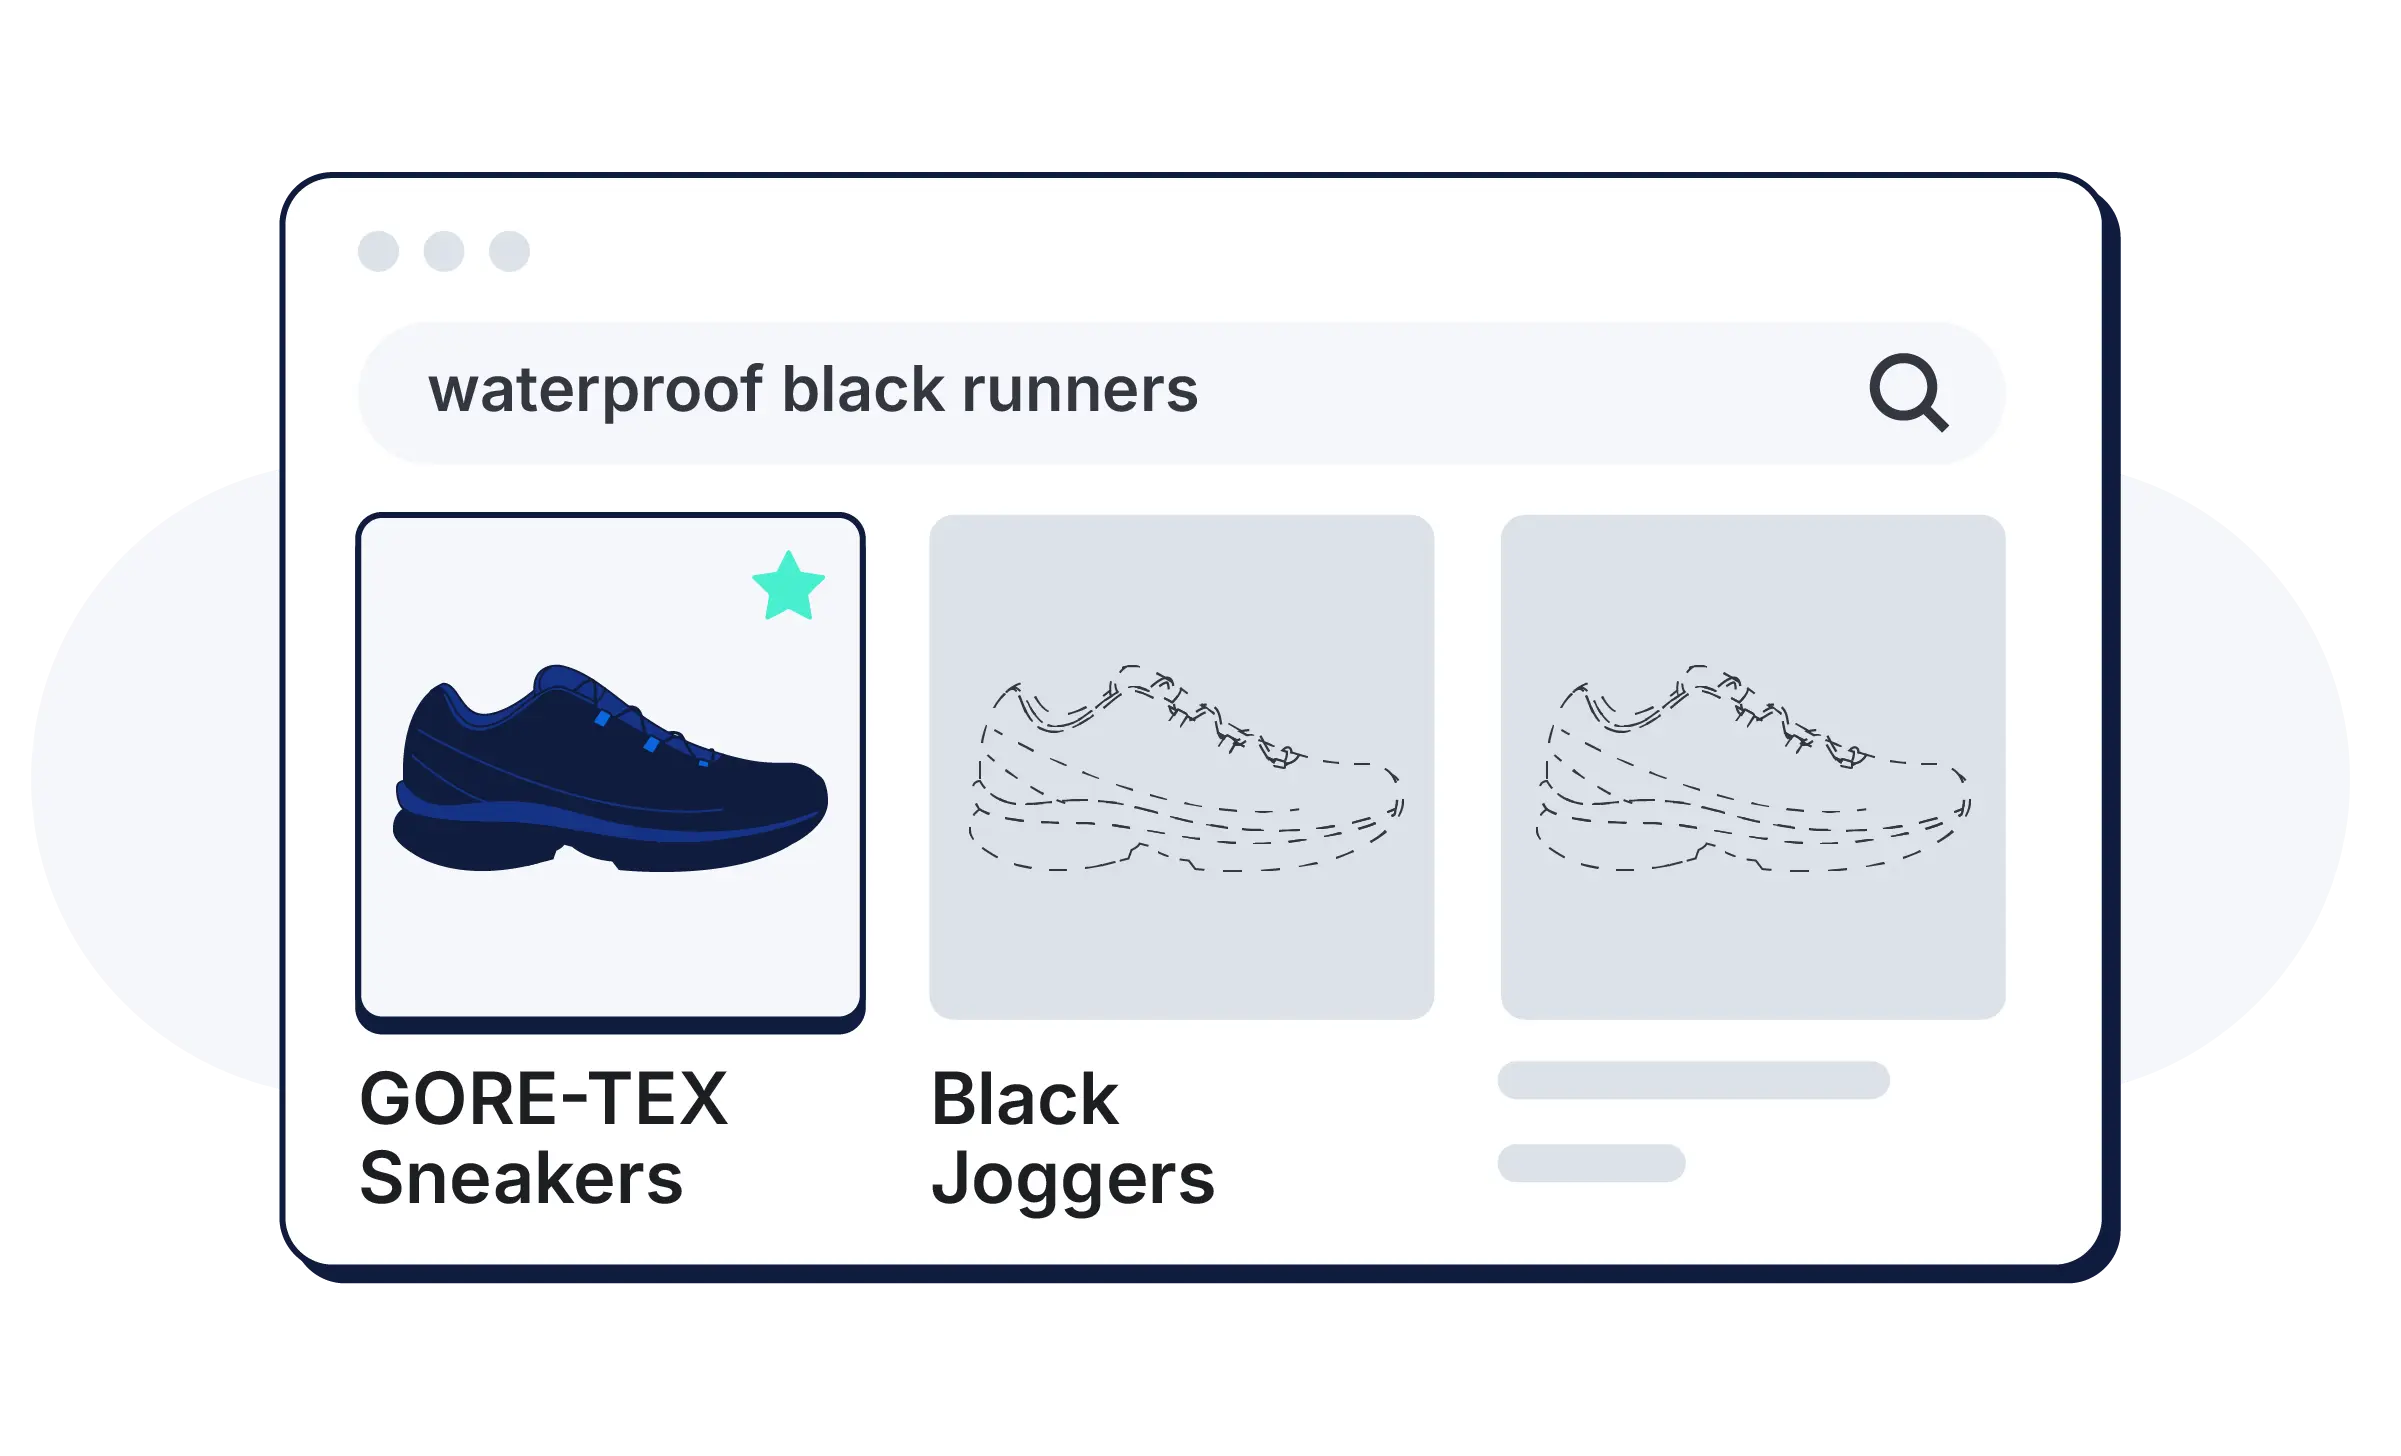
Kompaktes Design, präzise Ergebnisse
Verwandeln Sie Dokumente mit einer API in saubere, strukturierte Daten und hochpräzise Suchergebnisse.

Verwenden Sie Jina-Modelle, wo immer Sie bauen
Von vollständig verwaltet bis selbstgehostet – Jina-Modelle treffen Sie dort, wo Ihre Daten gespeichert sind. Wählen Sie den Zugangsweg, der passt.
Unsere Forschung
Werden Sie Teil unserer Open-Source-Community
Die Modelle von Jina sind Openweight-Modelle und kostenlos auf Hugging Face erhältlich, mit Millionen monatlicher Downloads. Der Code ist öffentlich auf GitHub verfügbar. Die Community hat direkten Zugang zu unseren Entwicklern.
Greifen Sie auf unsere Modelle für Embeddings, Reranker und kleine LMs zu, um besser suchen zu können.
Häufig gestellte Fragen
Was sind Jina-Suchmodelle?
Was sind Jina-Suchmodelle?
Jina-Modelle sind Open-Source-Modelle mit Frontier-KI für den Abruf. Dazu gehören Embedding-Modelle für Vektoren, Reranker für Präzision sowie OCR und Reader zum Extrahieren und Strukturieren von Inhalten aus URLs und Dokumenten.
Brauche ich KI- oder Machine-Learning-Expertise, um Jina-Modelle zu nutzen?
Brauche ich KI- oder Machine-Learning-Expertise, um Jina-Modelle zu nutzen?
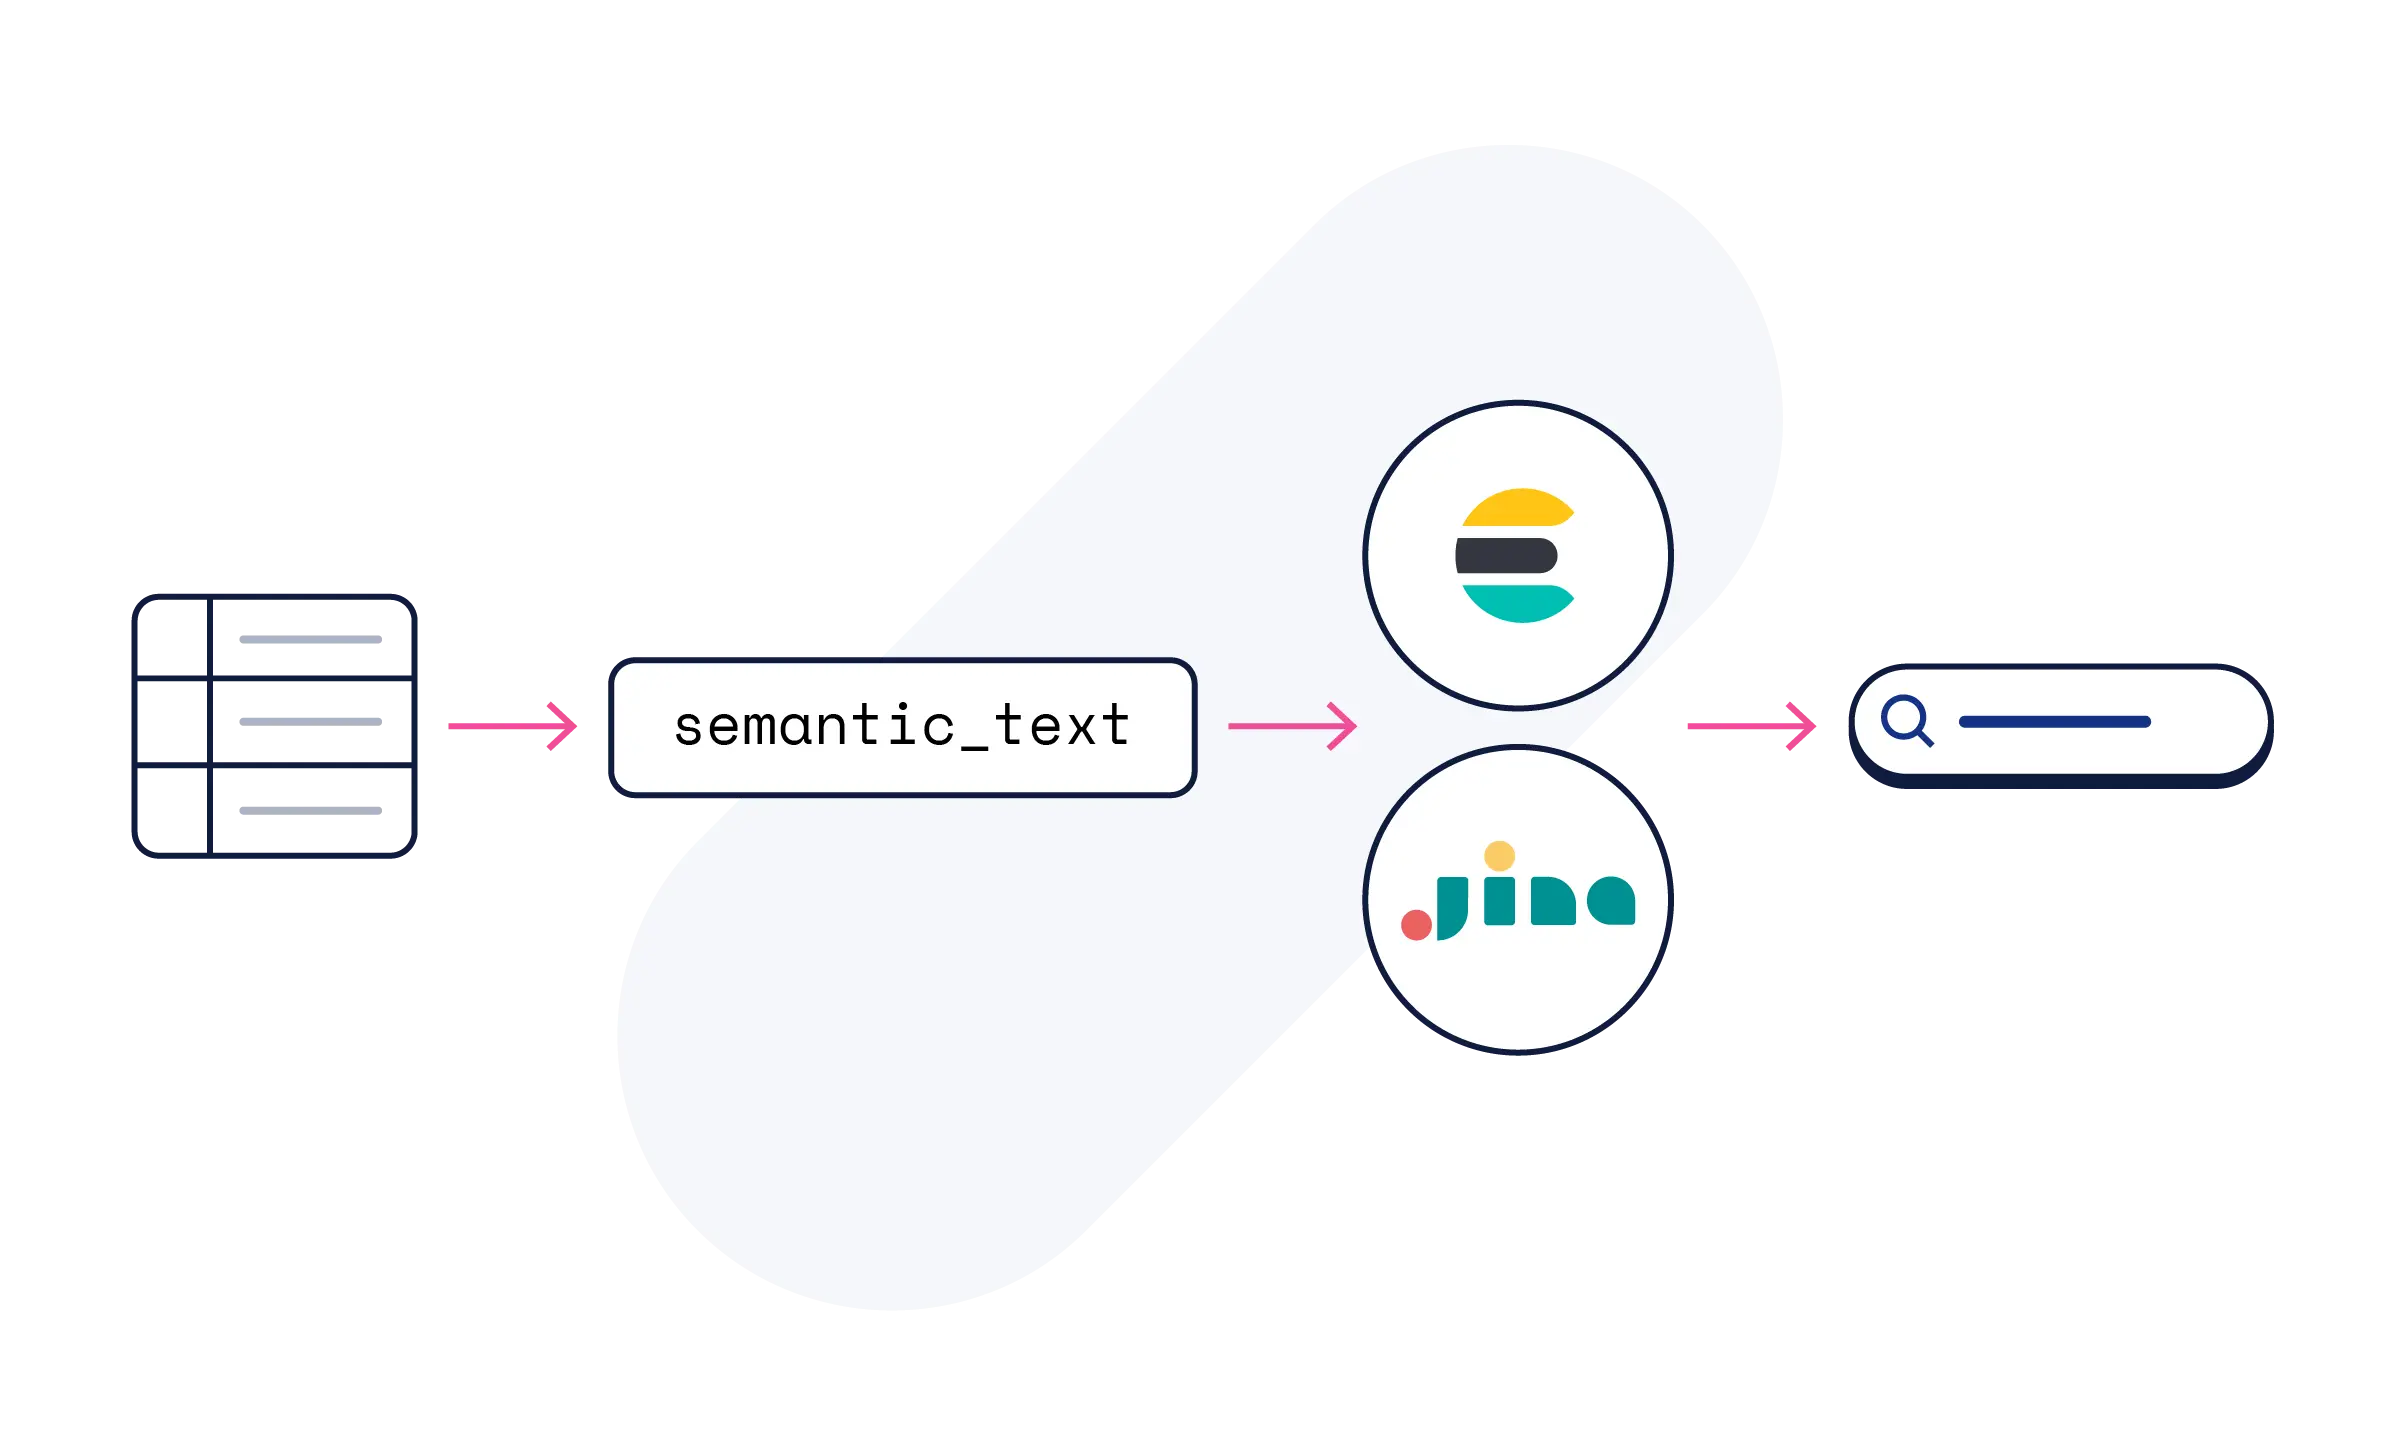
ML-Expertise ist nicht erforderlich. Jina-Modelle sind als vorkonfigurierte Endpoints in Elasticsearch verfügbar. Ordnen Sie ein semantic- oder semantic_text-Feld zu, dann werden die Einbettungen automatisch generiert.
Wie kann ich anfangen?
Wie kann ich anfangen?
Jina-Modelle sind auf Elastic Inference Service auf Elastic Cloud verfügbar und in allen Testversionen enthalten. Beginnen Sie mit der Definition eines semantic- oder semantic_text-Felds oder sehen Sie sich Modellkarten auf Hugging Face mit Codebeispielen an.
Welche Jina-Modelle sind heute verfügbar?
Welche Jina-Modelle sind heute verfügbar?
Die unterstützten Jina-Modelle im Elastic Inference Service werden in unserer Dokumentation zu Jina-Modellen ausführlich beschrieben.
Wie viele Sprachen werden unterstützt?
Wie viele Sprachen werden unterstützt?
Jina-embeddings-v5-omni und Jina-ocr-v1 unterstützen über 100 Sprachen. Abfragen in einer Sprache finden relevante Inhalte, die in einer anderen geschrieben sind, ohne dass Pipelines zur Übersetzung erforderlich sind.
Wie hängt das mit ELSER zusammen?
Wie hängt das mit ELSER zusammen?
Jina-Embedding-Modelle sind die Standardwahl für neue Projekte. ELSER wird weiterhin für Kunden unterstützt, die sich für seine Verwendung entscheiden. Beide sind im hybriden Such-Framework von Elasticsearch verfügbar.
Ist dies ein separates Produkt?
Ist dies ein separates Produkt?
Jina-Suchmodelle im Elastic Inference Service stehen allen Elastic Cloud-Nutzern mit verbrauchsabhängigen Preisen zur Verfügung. Es sind keine separate Lizenz, kein Abonnement und kein API-Schlüssel erforderlich. Jina-Modelle können separat als Teil von Jina On-Prem erworben werden.
Wie hängt das mit der Vektordatenbank-Seite von Elastic zusammen?
Wie hängt das mit der Vektordatenbank-Seite von Elastic zusammen?
Die Vektordatenbank-Seite behandelt, wie Vektoren skaliert gespeichert und gesucht werden. Diese Seite behandelt die KI-Modelle, die sie generieren und neu anordnen. Zusammen: Speicher, Rechenleistung und Anwendung.